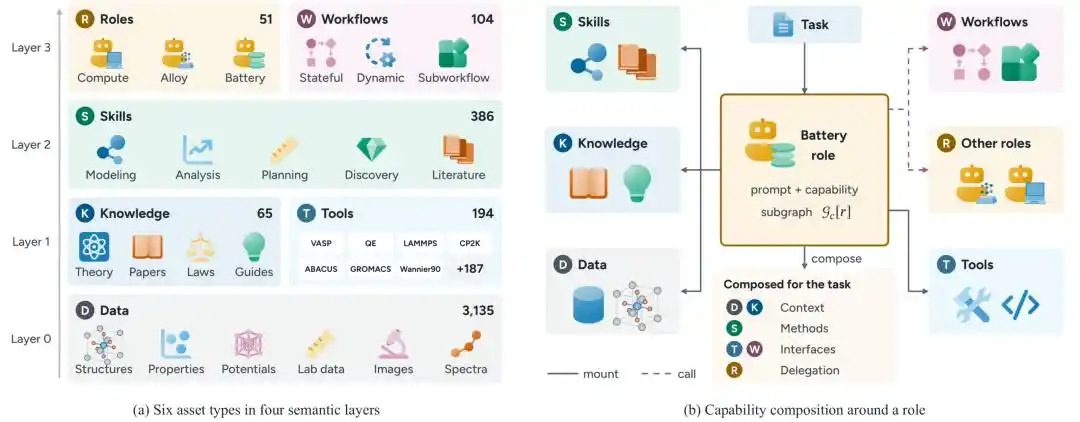
MatOS organiza los datos, el conocimiento, las herramientas, las habilidades, los roles y los flujos de trabajo () en seis categorías de activos científicos ().
Cada activo cuenta con una identificación única, relaciones de dependencia definidas y registros de origen; es posible guardar el contenido directamente o hacer referencia a bases de datos externas o software de cálculo.
Los activos están conectados entre sí a través de relaciones tipificadas (dependencias, llamadas, pruebas, verificaciones, etc.). Cuando un agente recibe una tarea, combina las capacidades necesarias basándose en estas relaciones.
Las habilidades representan procedimientos operativos para abordar problemas de investigación; especifican cuándo utilizarlas, cómo seleccionar métodos, qué premisas son necesarias, cómo ejecutarlas y cómo verificar los resultados. Los roles son agentes inteligentes definidos por sus responsabilidades y los activos a los que pueden acceder. Los flujos de trabajo describen cómo se conectan las diferentes etapas de una investigación. Una misma habilidad puede ser utilizada por múltiples roles, y un mismo rol puede participar en diferentes flujos de trabajo.
Tanto los investigadores como MatOS mismos pueden crear nuevas capacidades a partir de los activos existentes.
Los investigadores pueden registrar bases de datos, software o métodos como activos y combinarlos en habilidades, roles o flujos de trabajo según sus interfaces y relaciones de dependencia. MatOS también puede crear o revisar nuevos activos basándose en la evidencia de las tareas, para su reutilización en tareas futuras. El uso y la revisión de los activos están documentados, lo que permite rastrear cada mejora.
△
Flujos de trabajo adaptativos y con estado: ejecución estable y ajustes según sea necesario.
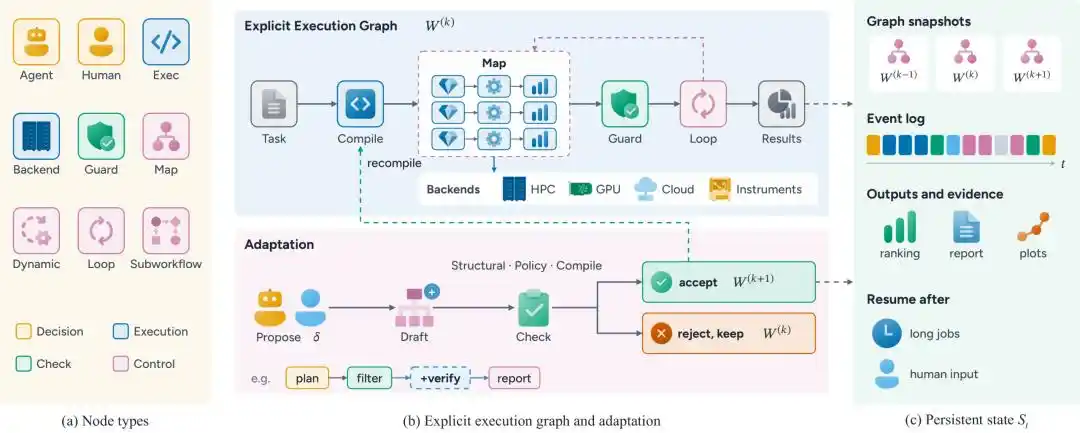
Los activos de flujo de trabajo son descripciones de procesos reutilizables; una investigación concreta se lleva a cabo a través de un grafo de ejecución. Cada nodo del grafo especifica el objetivo, las entradas/salidas, las condiciones de finalización y los activos utilizados. El sistema programa y verifica el proceso, dejando que los agentes se encarguen de las decisiones que requieran juicio (como la selección de métodos o el ajuste de planes). Los pasos que necesitan confirmación por parte de los investigadores pueden ser gestionados manualmente.
Dado que los modelos grandes pueden generar resultados diferentes con la misma entrada, las decisiones en tareas prolongadas pueden desviarse del objetivo dependiendo del contexto. Por lo tanto, MatOS reduce la dependencia de las sesiones del modelo mediante pasos y condiciones de verificación explícitos, disminuyendo el riesgo de desvíos.
Los estados de los nodos, los resultados y los registros de eventos del grafo de ejecución se almacenan en el sistema, independientemente de las sesiones del modelo.Los cálculos que llevan días se ejecutan en segundo plano; el sistema notifica al agente cuando se completan, se requiere una entrada o se produce una interrupción. Las tareas que esperan resultados externos o intervención humana mantienen su progreso y continúan ejecutándose. Cada resultado está vinculado al nodo que lo generó y al intento de ejecución.
Los resultados intermedios pueden requerir ajustes en los pasos posteriores (por ejemplo, realizar una verificación adicional antes de continuar con el análisis). En estos casos, el agente o el investigador puede proponer modificaciones al grafo de ejecución (), añadiendo o modificando nodos o relaciones de dependencia. Las propuestas de ajuste pasan por tres verificaciones (estructural, estratégica y de compilación); si son aprobadas, se crea una nueva versión del grafo de ejecución; de lo contrario, se sigue utilizando el original.
Los ajustes al grafo de ejecución sirven primero al tarea actual. Las mejoras que tengan valor de reutilización se incorporan como parte de los activos y, tras verificación y revisión, se utilizan para modificar los flujos de trabajo correspondientes en tareas futuras.
△
Evolución de los activos basada en la evidencia: mejoras continuas durante su uso.
Los errores de los usuarios, los fallos en el uso de herramientas y los resultados repetidos de los flujos de trabajo pueden indicar la necesidad de mejorar un activo.MatOS primero evalúa si la evidencia es suficiente, si el problema es real y si la experiencia previa puede ser reutilizada; luego identifica el activo responsable de la función en cuestión. Por ejemplo, un error en la selección de método puede requerir la revisión de conocimientos o habilidades, un error en el comportamiento de una herramienta puede requerir su reparación, o la modificación de un flujo de trabajo. En algunos casos, se crean nuevos activos o se revisan varios activos relacionados.
Por ejemplo, si los comentarios indican que el tiempo de equilibrio en una simulación de dinámica molecular es demasiado breve, el sistema puede cambiar este valor de 50 ps a al menos 200 ps y agregar una verificación para asegurarse de que la difusión de los átomos ha alcanzado un estado estable.
Los cambios propuestos deben someterse a una revisión estructural y a un análisis semántico basado en modelos: la revisión estructural determina si se han introducido nuevas estructuras, interfaces o errores de combinación; el análisis semántico verifica si los cambios responden a las pruebas originales, mantienen las condiciones de aplicabilidad de los métodos y son coherentes con los activos relacionados. Solo los cambios que pasan estas revisiones serán aceptados, y los resultados de las tareas posteriores se utilizarán como pruebas para la siguiente ronda de evaluación. Estas experiencias se almacenan en activos externos al modelo, y los parámetros del modelo de lenguaje base se mantienen inalterados; además, los activos no están vinculados a un modelo específico; en las evaluaciones, el mismo conjunto de MatOS se ha utilizado con GPT-5.4 y modelos de la serie DeepSeek. El proyecto ResearchClawBench requiere que los sistemas realicen investigaciones basadas en la literatura y datos originales y presenten informes. El equipo seleccionó 12 tareas en los campos de la química, la energía y los materiales y las comparó con 7 agentes inteligentes científicos que utilizan GPT-5.4, como MIRA, ResearchClaw, EvoScientist y Codex CLI. Al utilizar GPT-5.4, el promedio de puntuación de MatOS fue de 19.46, un 11.15% más alto que el mejor resultado de referencia (MIRA) y un 33.6% más alto que el de Codex CLI. El rendimiento de MatOS en las tareas relacionadas con los materiales fue aún más destacado: un 18.7% más alto que el de MIRA y un 80.8% más alto que el de Codex CLI. Cuando se cambió a la versión más económica de DeepSeek (DeepSeek -V4-Flash), el promedio de puntuación de MatOS fue de 19.20, también superior a todos los resultados de referencia. En términos de costos, la configuración de DeepSeek -V4-Flash tiene un costo promedio por tarea de aproximadamente 0.85 dólares, menos de un tercio del costo de Codex CLI (2.70 dólares), y logró una puntuación más alta; la configuración con GPT-5.4 obtuvo la puntuación más alta con un costo de aproximadamente 3.78 dólares. Ambas configuraciones de MatOS expandieron el “fronte de Pareto de costos-puntuación” en esta evaluación, es decir, encontraron un conjunto de opciones óptimas que presentan compromisos entre varios objetivos, sin que ninguna de ellas pudiera superar completamente a las demás opciones. En los benchmarks de uso de software para materiales (MatTools) y en el benchmark de llamadas a herramientas múltiples (SciAgentGym), los tres sistemas (MatOS, Codex CLI y Claude Code) utilizaron la base de DeepSeek -V4-Pro. El índice de éxito total de MatOS en MatTools fue del 97.96%, superior al 95.92% de Codex CLI y al 89.80% de Claude Code; el índice de éxito en las subtareas fue del 97.10% para MatOS, en comparación con el 95.65% para Codex CLI y el 91.30% para Claude Code. En SciAgentGym, el índice de éxito de MatOS fue del 59.5%, superior al 57.1% de los otros dos sistemas. Los 8 casos de estudio abarcan áreas como el aprendizaje automático, los electrolitos sólidos y líquidos, las aleaciones, y también la hidrodinámica. Los tipos de tareas incluyen cribado a gran escala, simulación molecular, diseño de fórmulas y desarrollo de nuevos métodos. En el cribado a gran escala, MatOS utilizó un enfoque estratificado propuesto por Du et al.: primero se realizó un cribado preliminar rápido utilizando un modelo basado únicamente en la composición química, luego se realizó un cribado más detallado con una red neuronal gráfica que predice las propiedades basadas en la estructura cristalina, y finalmente se simuló el movimiento de los iones mediante dinámica molecular para evaluar las propiedades de conductividad, estabilidad electroquímica y propiedades mecánicas. De las 30,364,908 estructuras iniciales, se seleccionaron 97 candidatos para electrolitos sólidos, entre los cuales el mejor presentó una conductividad eléctrica de hasta 59.0 mS/cm.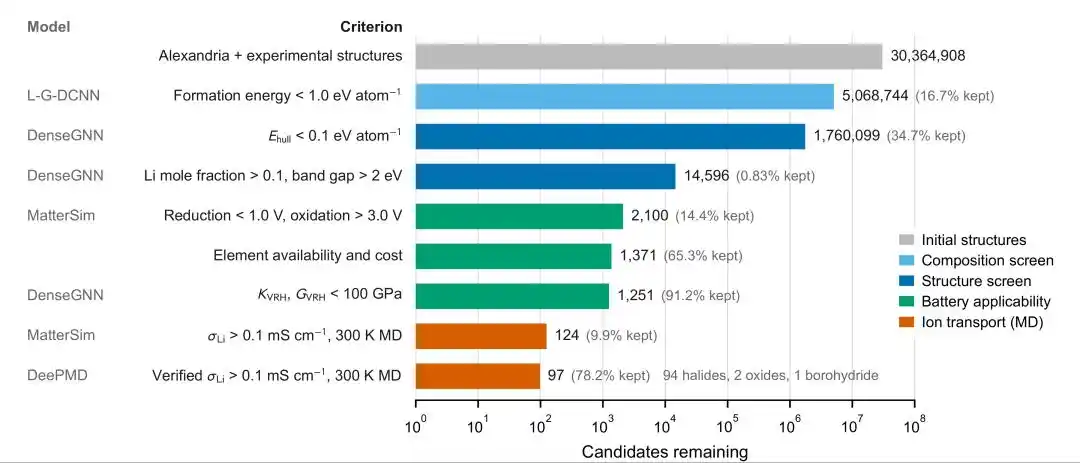
△
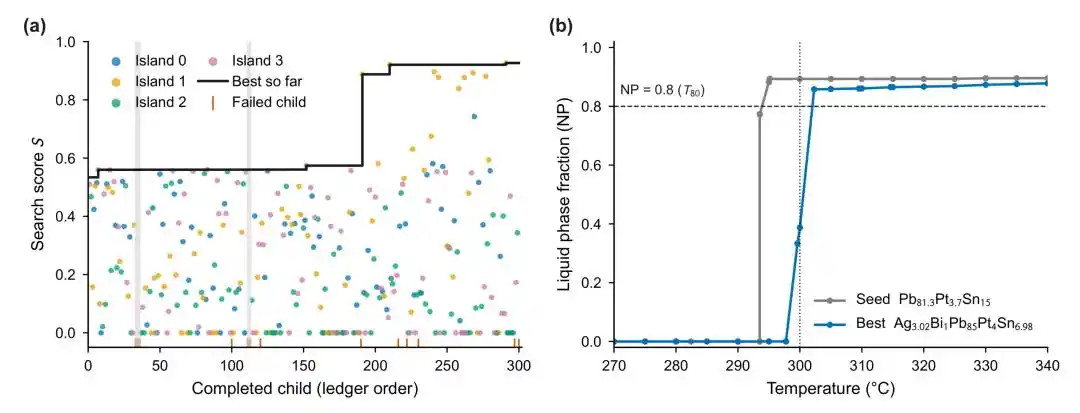
En el diseño de fórmulas y en el proceso de encapsulación de semiconductores, MatOS busca aleaciones que comiencen a derretirse alrededor de 300°C y cuyo rango de temperatura de fusión sea estrecho. El modelo principal propone candidatos en cuatro grupos simultáneamente; un modelo proxy (un método de cálculo aproximado rápido) predice la proporción de fase sólida a fase líquida para cada fórmula a diferentes temperaturas, y los resultados de la evaluación guían la siguiente ronda de búsqueda.
De los 286 compuestos evaluados, el puntaje más alto aumentó de 0.534 (para el compuesto inicial) a 0.927; se estima que la aleación Pb–Ag–Pt–Sn comienza a derretirse a 297.75°C, y después de un aumento de temperatura de 4.55°C, la proporción de fase líquida alcanza el 80%.
△
En el desarrollo de nuevos métodos, el equipo de investigación utilizó MatOS para crear un flujo de trabajo de aprendizaje activo: el sistema selecciona las fórmulas de aleaciones que requieren cálculos termodinámicos, y luego entrena el modelo nuevamente basándose en los resultados de los cálculos; así, los datos y el modelo se expanden de manera sincrónica.
DuoCompNet, desarrollado en este proceso, se utiliza para predecir el punto medio del rango de temperatura en el que las aleaciones que contienen estaño comienzan a derretirse hasta que se derriten completamente. A medida que aumentan los datos de entrenamiento, el error absoluto promedio de DuoCompNet en un conjunto de prueba fijo disminuyó de 28.40°C a 3.18°C, siendo el más bajo de los seis modelos comparados (un 13.6% más bajo que el segundo mejor resultado, Roost); el conjunto de prueba incluye 1,401 puntos medios de rangos de fusión entre 200°C y 400°C, compuestos por dos o tres elementos, con valores de referencia obtenidos de cálculos termodinámicos.
El método de selección de datos de entrenamiento desarrollado con MatOS, llamado RarityGuard-MP, seleccionó 100,000 estructuras de un total de aproximadamente 1.26 millones para entrenar modelos de aprendizaje automático. Con la misma cantidad de datos, el error combinado en energía, fuerza y tensión de los modelos entrenados fue un 3.10% más bajo que el método EC-T.
Resumen y perspectivas
MatOS conecta la construcción de capacidades, la ejecución de tareas y la evolución de los recursos: los investigadores pueden integrar sus propios datos, software y métodos; el sistema puede proponer revisiones a los recursos basándose en la evidencia de las tareas realizadas. Los recursos y revisiones aprobados pasan a ser disponibles directamente para futuras investigaciones, lo que evita tener que comenzar desde cero.
El próximo paso de MatOS será integrar instrumentos y procesos experimentales, permitiendo que toda la información, desde la selección computacional hasta la verificación experimental, esté vinculada en un solo sistema.Informe técnico: MatOS: Un sistema operativo para la investigación de materiales.
Enlace al informe: https://arxiv.org/abs/2610.34203@@
Código fuente: https://github.com/DingyangLyu/MatOSAI@@
Correo electrónico del Instituto de Investigación de Materiales: aimaterials@bza.edu.cn@@Este artículo proviene del cuenta WeChat oficial “Cuantum Bit”, autor: Yun Zhong.